Агенты с искусственным интеллектом становятся лучше, предвидя ошибки в своих собственных изменениях программного обеспечения
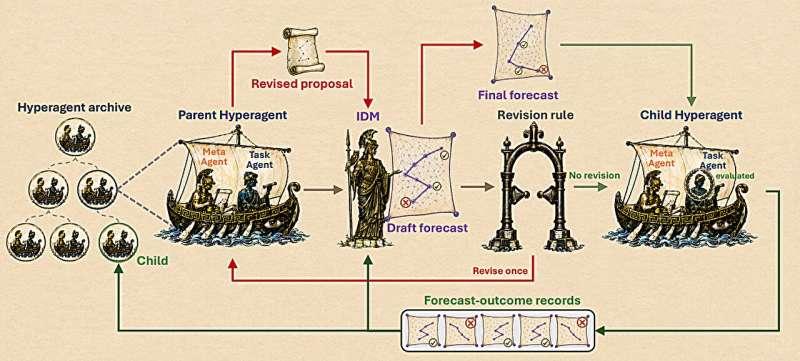
Некоторые агенты искусственного интеллекта могут модифицировать программы и инструкции, управляющие их собственной работой, с целью повышения производительности. Однако эти изменения могут привести к ошибкам, а тестирование неудачных модификаций потребляет ресурсы. Исследователи из Университета Вирджинии, Microsoft Research и Университета Цинхуа недавно разработали программное обеспечение для прогнозирования, которое помогает агентам искусственного интеллекта предвидеть последствия предлагаемых изменений перед тестированием модифицированного программного обеспечения.
Подход, описанный в статье, размещенной на сервере препринтов arXiv, был оценен при решении задач программирования, прогнозировании того, будут ли приняты научные статьи к публикации, разработке вознаграждений для имитируемых роботов и оценке передовых математических решений. Первоначальные результаты показывают, что использование прогнозов для управления изменениями в программном обеспечении помогло агентам повысить эффективность работы.
Прогнозирование проблем перед тестированиемПодход исследователей основан на HyperAgents - платформе, объединяющей два компонента искусственного интеллекта, или агента. Первый выполняет задачи, в то время как второй изменяет код и инструкции, используемые обоими. Более ранние версии и их результаты сохраняются в архиве для информирования о последующих изменениях.
Команда представила новый компонент под названием "Модель динамики улучшений", который анализирует предлагаемую модификацию, изменяемый агент и более ранние результаты. Он также предсказывает результаты для отдельных задач, различая неправильные ответы и попытки, которые никогда не заканчиваются.
Важно проводить различие между неправильными ответами и незавершенными попытками, поскольку они могут потребовать различных вмешательств. Неправильный ответ может потребовать более тщательного обоснования, в то время как незавершенная попытка может указывать на то, что программное обеспечение нуждается в исправлении.
Если прогноз, скорректированный с учетом погрешности предыдущего прогноза, показывает худшую производительность, чем измеренная производительность текущего агента, модифицирующий компонент получает прогноз и еще одну возможность для пересмотра.
Полученный агент тестируется независимо от окончательного прогноза. Изменения влияют на его программное обеспечение и инструкции, в то время как значения базовой языковой модели остаются неизменными.
В одном из примеров, описанных исследователями, при редактировании инструкции были заключены в кавычки, что нарушило работу программы. Модифицирующий агент распознал ошибку, но исчерпал все возможности своего инструмента, прежде чем исправить ее.
Прогнозист предсказал незавершенные задачи, что вызвало необходимость внесения еще одной правки. После исправления кавычек и проверки синтаксиса обновленный агент выполнил 11 заданий.
Comparing agent performance and resource useThe researchers conducted five runs with 40 improvement rounds each for every experimental condition. They found that their forecasting approach developed stronger coding agents earlier than HyperAgents.
On 166 programming tasks kept separate from improvement and selection, selected agents achieved a median success rate of about 30%, compared with 22% for HyperAgents and 16% for their shared starting agent. Success required producing a software patch that passed task-specific tests.
The researchers also compared the approaches with matching budgets for language model tokens, the units of text processed or generated, and found that the forecasting approach retained a performance advantage. This comparison accounted for tokens used in modification, forecasting, forecast updates and task evaluation, but did not measure total computing cost.
Applying experience in another fieldThe team's forecasting software can also improve. Every five rounds, the system proposes updates and checks their predictions against subsequently recorded outcomes before deciding whether to adopt them.
The team also tested whether the experience it gained could be transferred to new tasks by applying a forecaster developed jointly on paper-acceptance prediction and reward design for simulated robots to mathematical grading. During these tests, the researchers started with fresh task-solving and modifying programs.
Across 100 unseen grading tasks, selected agents exactly matched expert grades with a median accuracy of 55%. Agents using a fresh forecaster achieved 51%, while those relying on HyperAgents reached 47%.
These benchmark findings do not establish that AI agents can replace human reviewers, graders or programmers. Instead, they suggest that forecasting can help agents identify helpful software changes, and that experience predicting these changes could assist improvement on a different task.
© 2026 Science X Network
>