Целенаправленный отбор данных может примерно втрое ускорить тонкую настройку ИИ
Может ли тонкая настройка ИИ, на которую раньше уходило 10 часов, быть завершена всего за три часа? Исследователи KAIST разработали технологию, которая отбирает наиболее полезные обучающие данные и равномерно распределяет их по нескольким графическим процессорам.
За счет сокращения повторяющегося изучения однотипных данных этот метод сократил время обучения до 69,6% при сохранении почти такой же производительности искусственного интеллекта. Ожидается, что эта технология поможет быстрее и с меньшими затратами разрабатывать искусственный интеллект, адаптированный к конкретным задачам, таким как обслуживание корпоративных клиентов или помощь медицинским работникам в поиске информации.
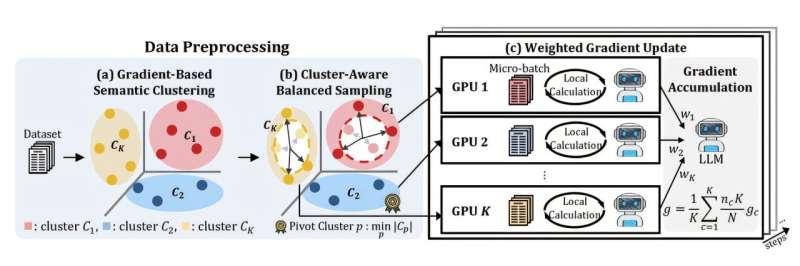
Исследовательская группа под руководством профессора Чжэ-Гил Ли из Школы вычислительной техники разработала "Кластер" - технологию тонкой настройки большой языковой модели, которая группирует и выбирает данные, оказывающие сходное влияние на обучение, и равномерно распределяет их по нескольким графическим процессорам.
Результаты исследования были представлены в октябре 2026 года на конференции по эмпирическим методам обработки естественного языка (EMNLP 2026) и доступны на сервере препринтов arXiv.
Хенджин Ким, докторант компьютерной школы KAIST, участвовал в исследовании в качестве первого автора, а Ли - в качестве автора-корреспондента. Янгун Нам, научный сотрудник Университета Торонто, получивший докторскую степень, и Джемин Хан и Вонхек Чой, магистранты Высшей школы данных KAIST, приняли участие в качестве соавторов.
Случайное распределение повторяет аналогичное обучениеБольшая языковая модель должна быть дополнительно обработана на соответствующих данных, прежде чем ее можно будет использовать в конкретной области, такой как программирование или медицина. Этот процесс называется "тонкой настройкой". Это похоже на обучение ИИ, который хорошо разбирается в задачах и решениях по кодированию или медицинских вопросах и ответах на них, чтобы он мог более эффективно выполнять задачи в этой конкретной области.
Этот процесс требует значительных вычислений, поэтому несколько графических процессоров разделяют данные и обрабатывают их параллельно. Графический процессор - это полупроводниковое устройство, способное быстро выполнять вычисления, необходимые для обучения ИИ. Точно так же, как несколько человек могут разделить большой набор задач и решать их сообща, несколько графических процессоров разделяют обучающие данные, обрабатывают их и объединяют результаты для улучшения единой модели ИИ.
Однако, если данные распределены случайным образом, несколько графических процессоров могут многократно обрабатывать данные, которые оказывают схожее влияние на обучение. Это похоже на то, как если бы студент неоднократно решал задачи, которые очень похожи на те, которые он уже освоил, что приводит к относительно небольшому дополнительному обучению по сравнению с требуемым объемом вычислений.
Поэтому исследовательская группа сосредоточилась не только на том, "на каком объеме данных проводить обучение", но и на том, "какие данные отбирать и как их распределять". Цель состояла в том, чтобы сократить количество повторяющихся занятий и в то же время обеспечить, чтобы ИИ не пропускал разнообразную информацию, необходимую для изучения.
Grouping data by learning effectCluSTER first analyzes how each piece of data affects AI learning and groups together data with similar effects. The grouping is not based simply on whether the data cover the same topic or use similar words. Even problems that look different on the surface are classified into the same group if they teach the AI similar problem-solving abilities.
For example, when teaching a student addition, a problem about combining two apples with three apples and a problem about combining two pencils with three pencils tell different stories, but the calculation being learned is the same. In this way, the research team identified and grouped data that had similar effects on learning even when they were expressed differently.
The system then selects data from each group and distributes them so that multiple GPUs process a diverse range of learning information evenly. It is similar to reducing repetitive problems in a workbook while making sure that all important types of problems remain and are divided among several people to solve. The key feature is that the method does not merely reduce the amount of data but also enables multiple GPUs to use the selected data efficiently.
Nearly unchanged performance with less trainingThe research team fine-tuned large language models with approximately 7 billion and 13 billion parameters using three training data sets from the coding and medical fields. Parameters are internal numerical values adjusted as an AI model learns and are used to reflect acquired knowledge in its responses. The team evaluated the effectiveness of the technology through a total of eight performance benchmarks.
In the experiments, the models maintained nearly the same performance even when trained on only about 31% of the full data set, while training time was reduced by up to 69.6%. Applying the maximum reduction rate, training that previously took 10 hours could be completed in about three hours. The research team primarily conducted experiments in an environment using four GPUs and also confirmed better performance than conventional methods in an eight-GPU environment.
This study shows that AI training efficiency can be improved without adding more GPUs if the training data are selected and distributed effectively. In the future, the technology is expected to help companies and research institutions reduce the time and GPU costs required for additional training when developing AI for specific purposes such as coding assistance or medical question answering.
Lee said, "To improve the efficiency of AI training, it is important not only to use more GPUs but also to intelligently select which data should be used for learning," adding, "This study is significant because it shows that existing GPU resources can be used more efficiently to reduce the training burden of large-scale AI models."
>